
20 h.
16 h.
Mouais...
Note: Only cooperative robots follow these rules, and a crawler first needs to access the resource to read headers and meta elements (see Interaction with robots.txt). If you want to prevent bandwidth consumption by crawlers, a restrictive robots.txt file is more effective than indexing rules as it blocks resources from being crawled.
https://developer.mozilla....
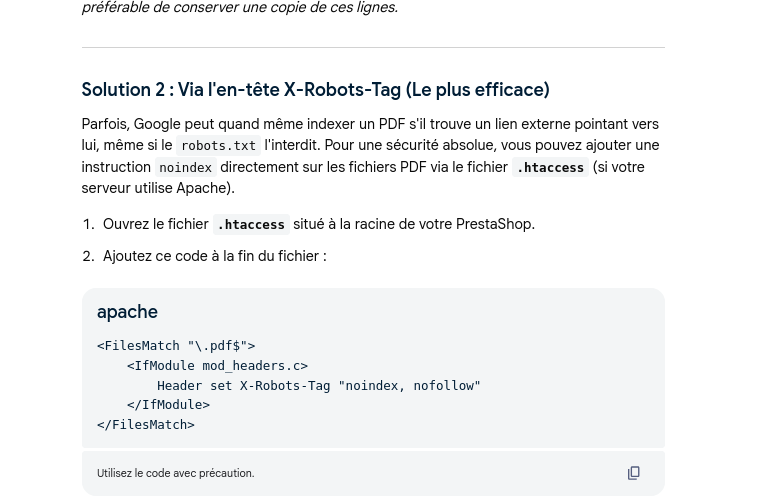
oui c'est pourquoi il faut retirer le disallow de robots.txt , à ce que je comprends , il faut que le bot puisse lire l'url et son header pour ne pas l'indexer , là actuellement il indexe mes pdf sans crawler le contenu car il trouve le lien externe dans la fiche produit. De toute façon , pour l'instant le robots.txt ne marche pas donc je vais essayer la méthode htaccess.